专为智能体 AI 时代打造
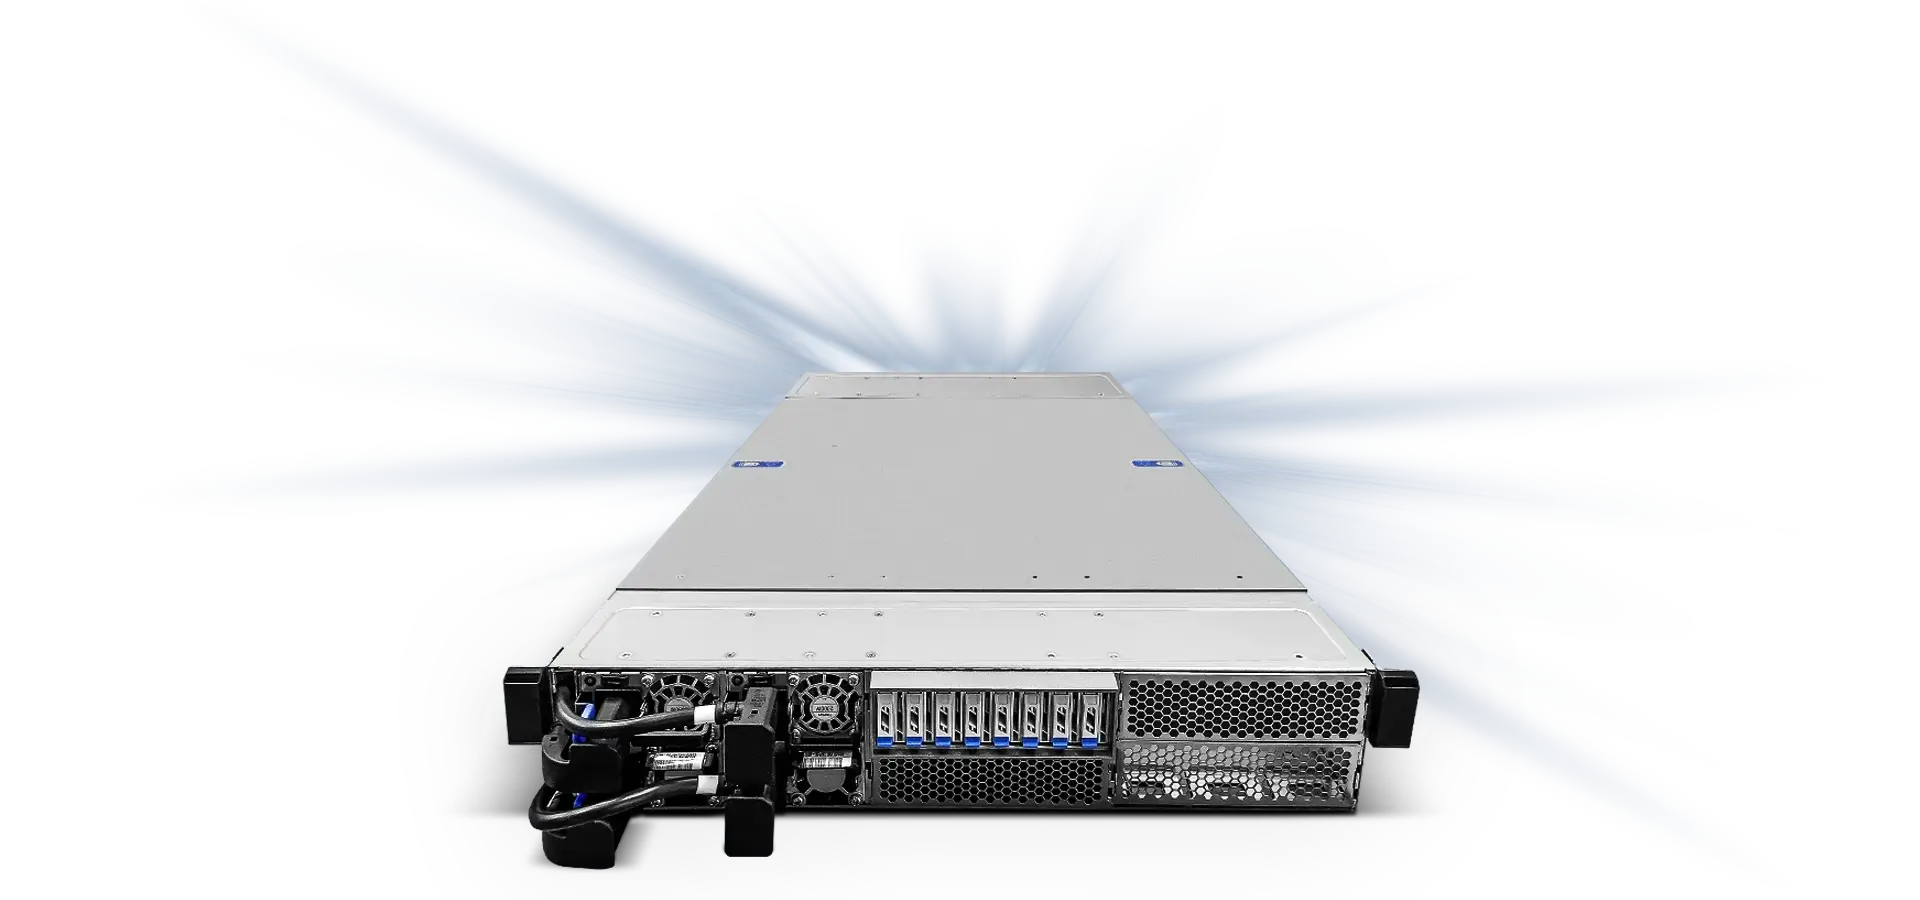
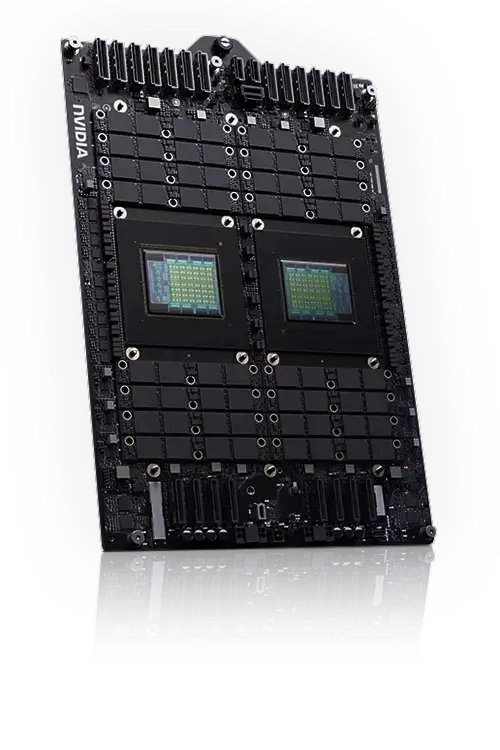
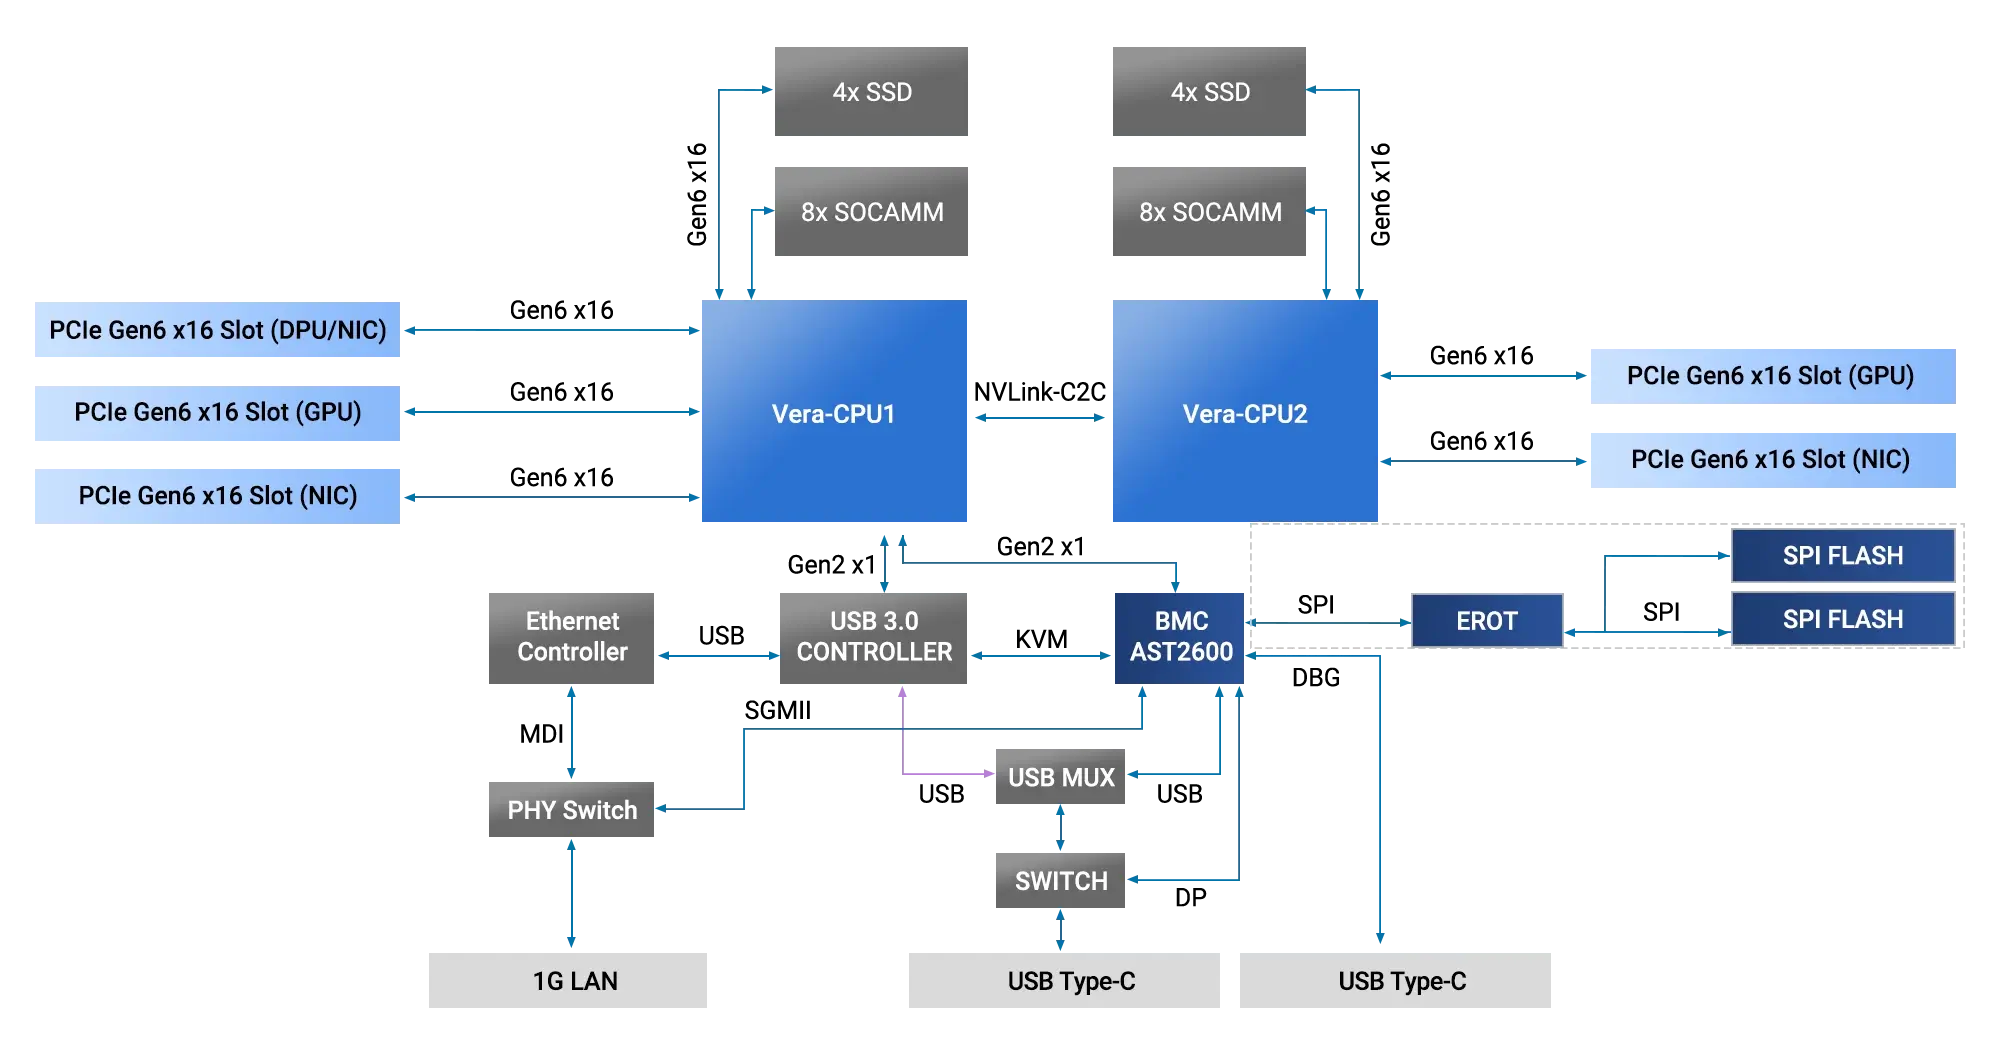
XA P2N-E2 是一款搭载 NVIDIA Vera 的服务器平台,该处理器为专为 AI 智能体打造的 CPU。每个 Vera CPU 均整合 88 个客制化 NVIDIA Olympus 核心,具备空间多线程技术,可提供 176 线程的智能体处理吞吐量。
- 3.4 TB/s 核心对核心带宽
- 1.8 TB/s NVLink™-C2C 支持,用于 CPU 对 CPU 通讯
- 降低 50% 内存功耗
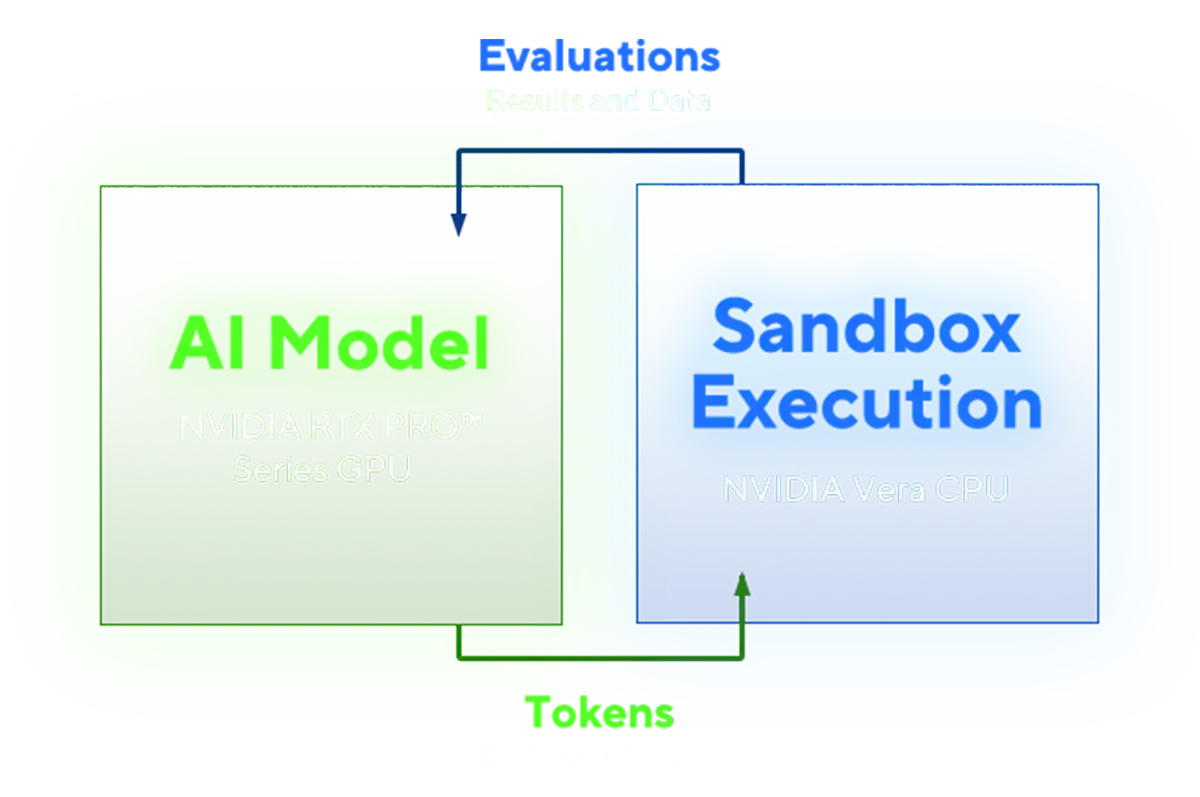
NVIDIA Vera CPU 负责处理每个 AI 智能体关键路径中受限于 CPU 性能的步骤——沙盒程序代码执行、工具使用、协调编排和数据处理——使 GPU 能够专注于训练与推论任务。
- AI 模型 / 智能体 (NVIDIA RTX PRO™ 系列 GPU) 发送 Token、程序代码与查询
- 沙盒执行 (NVIDIA Vera CPU) 回传评估结果、数据与数据
- 成果:减少智能体等待时间,大幅增加实际执行作业的时间
XA P2N-E2 搭载两个 NVIDIA Vera 处理器——专为 AI 智能体打造的首款 CPU。每个 Vera CPU 均建构于 88 个客制化 NVIDIA Olympus 核心之上,通过空间多线程技术提供 176 线程的智能体吞吐量,专为处理每个智能体关键路径上受限于 CPU 的步骤而设计:沙盒程序代码执行、工具使用、协调编排及数据处理。提供高达 1.2TB/s 带宽的 LPDDR5X 内存子系统可持续为运行中的核心提供数据,而第二代 NVIDIA NVLink™-C2C 互连技术则提供高达 1.8TB/s 的一致性 CPU 对 CPU 通讯。两者结合使 XA P2N-E2 能够大规模执行智能体沙盒工作负载,同时让 GPU 专注于训练与推论——进一步减少智能体等待的时间,并增加其执行任务的时间。
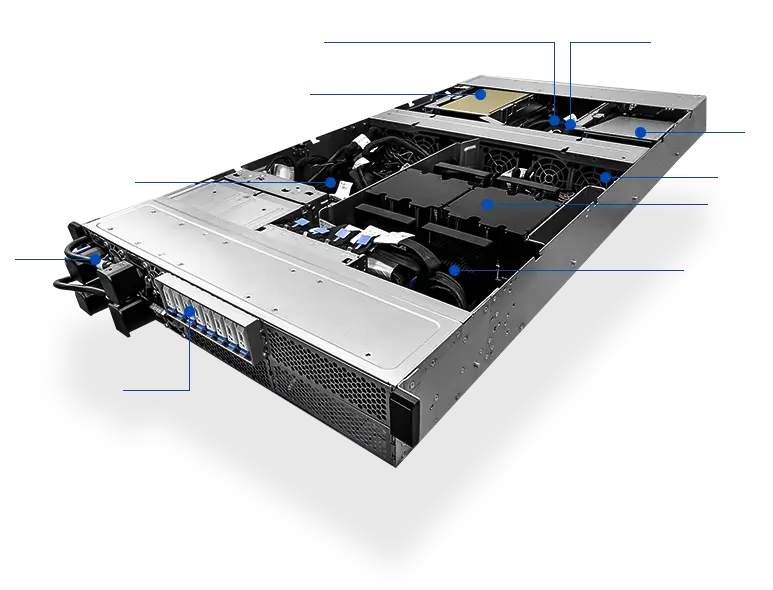
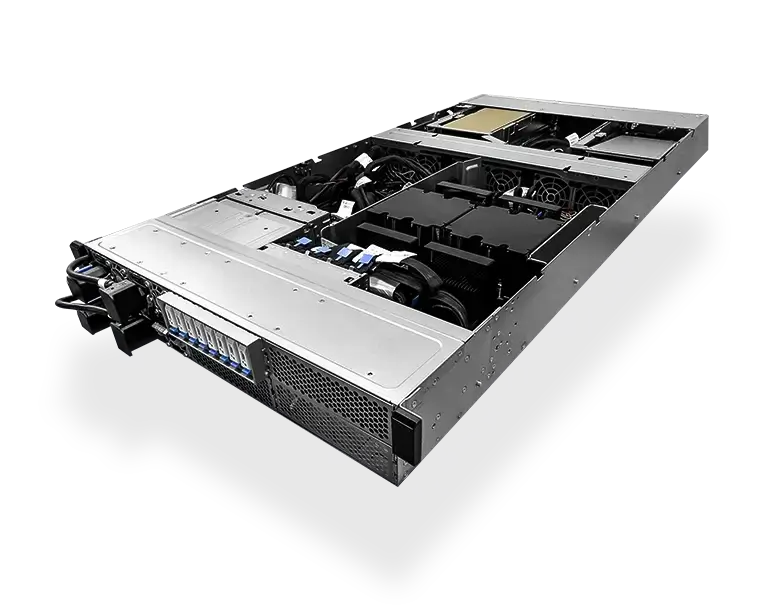
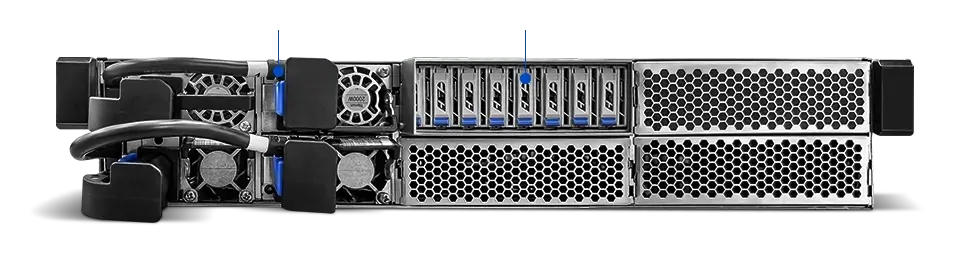
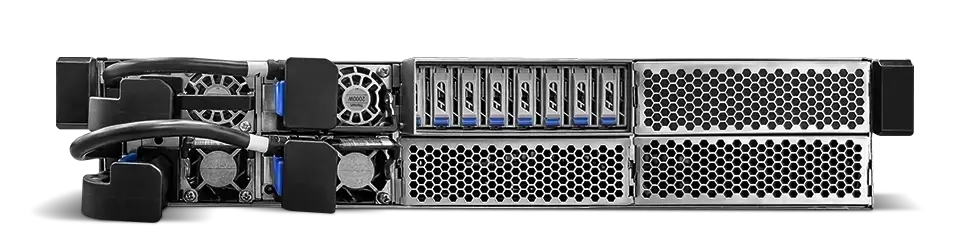
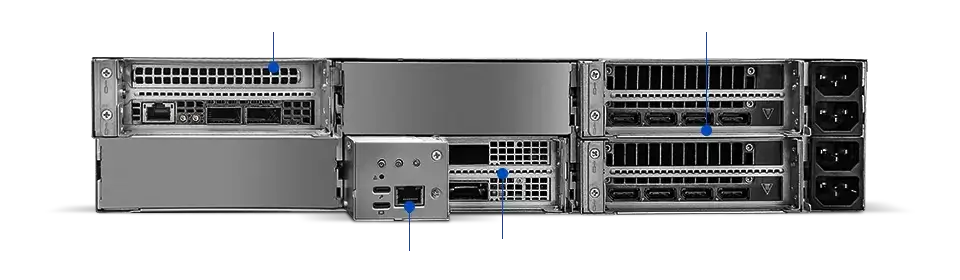
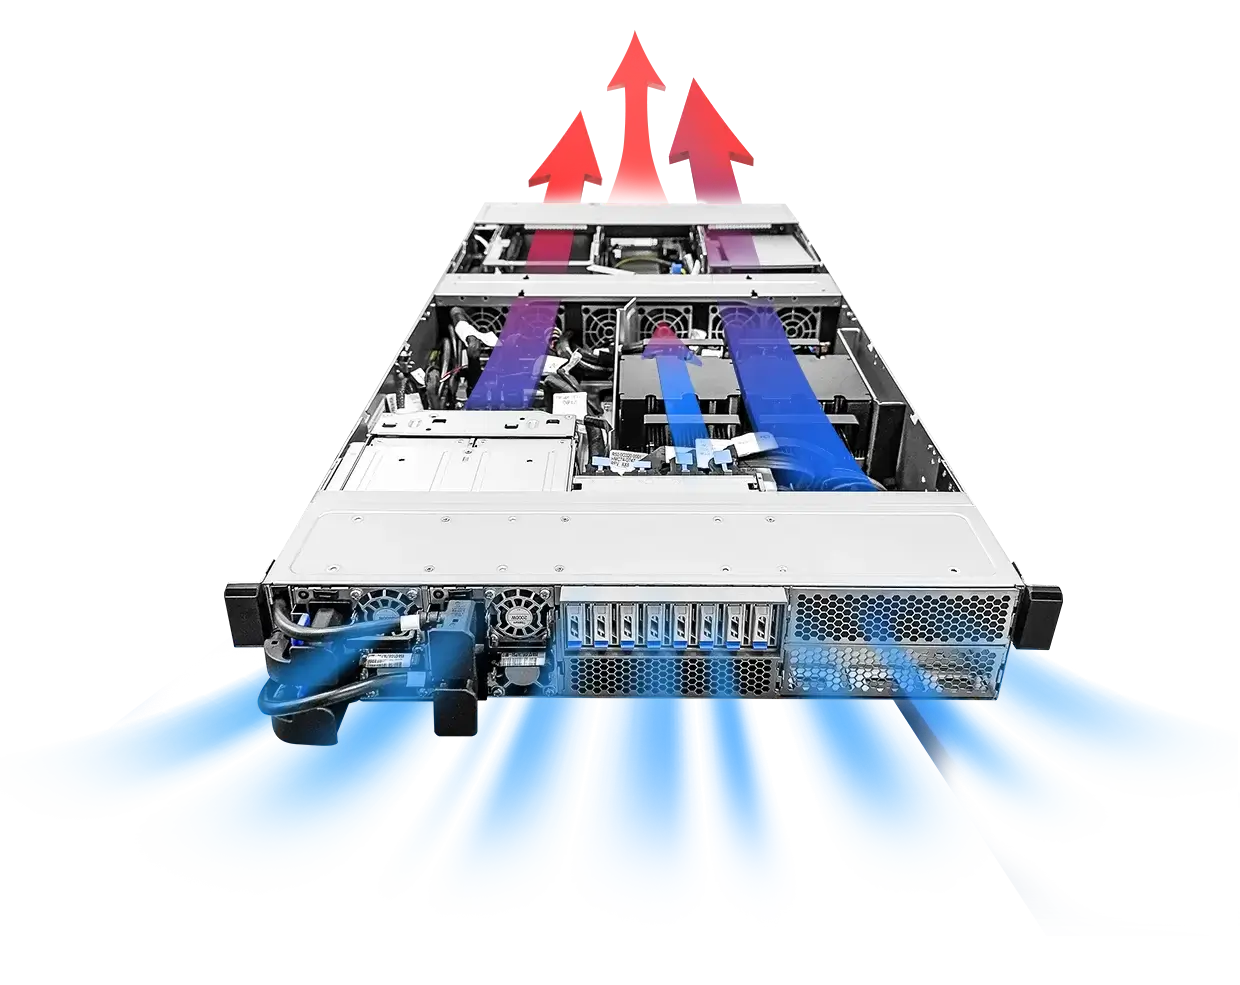
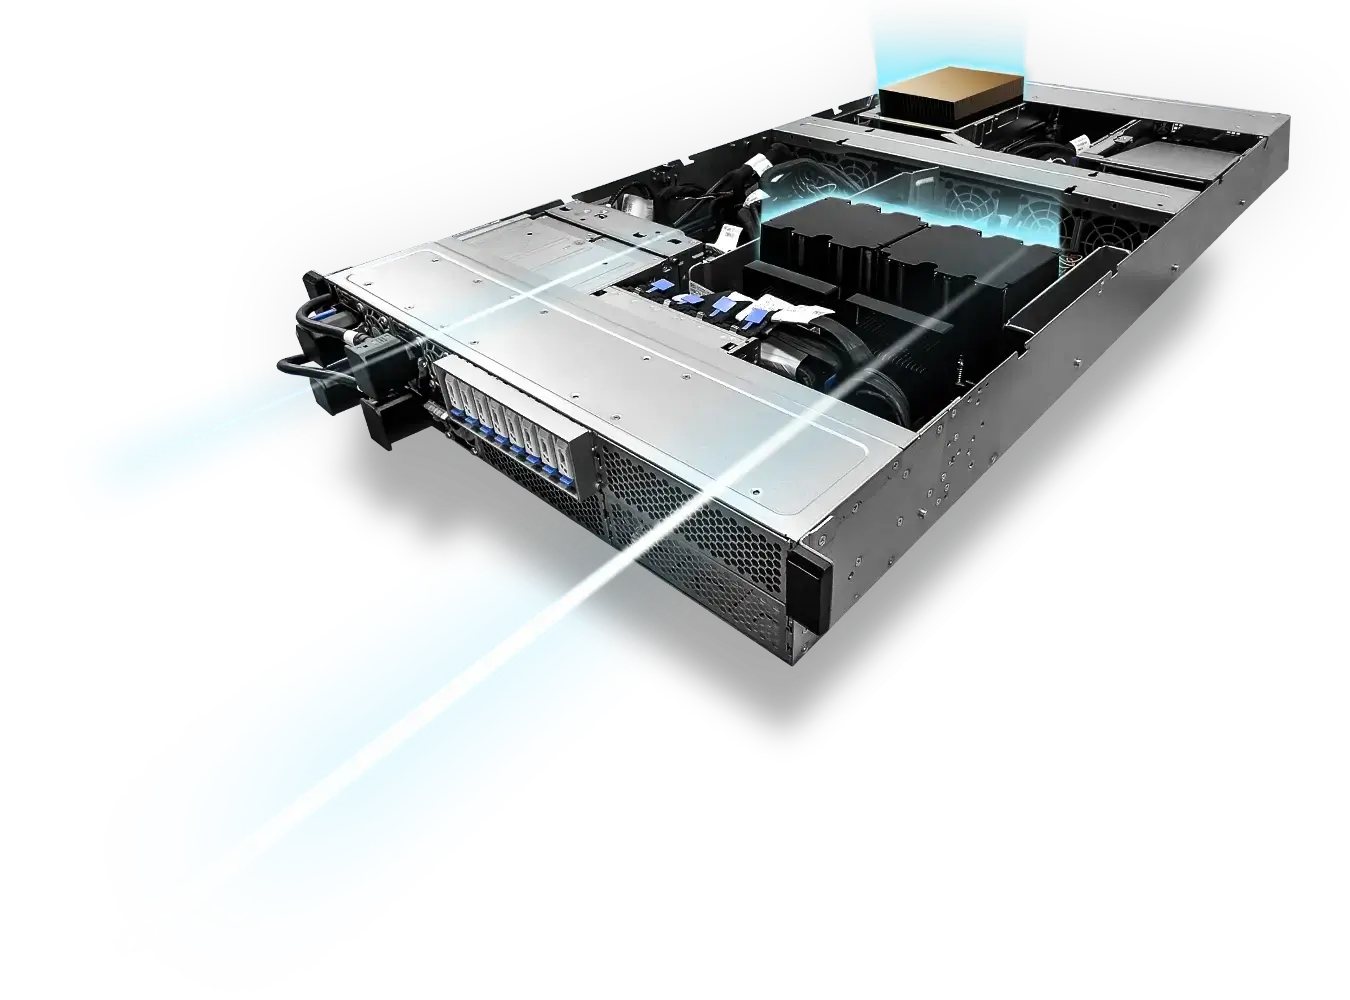
XA P2N-E2 采用全风冷散热设计,能让双每插槽 480W 的 NVIDIA Vera 处理器与双插槽 GPU 维持高效运行——完全无需水冷散热基础架构。跨 HPM (CPU)、SOCAMM2 内存和 GPU 区域的优化前后风道设计,可降低每生成一个 Token 的能耗,为企业提供更简单、更低 TCO 的途径以大规模部署智能体 AI。
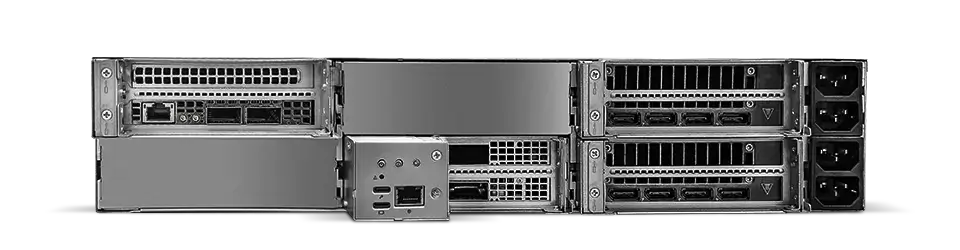
XA P2N-E2 完全兼容于 NVIDIA MGX™ 架构,专为智能体 AI 基础架构的快速、大规模部署而设计。其模块化设计使 IT 团队能够独立维护、升级或扩展 CPU 与 GPU 资源——缩短部署时间,并为客户提供经由验证的途径,随着需求增长灵活扩展智能体 AI 运算容量。
 1
2
1
GPU 模块舱
可容纳最多两张双插槽 NVIDIA RTX PRO™ 6000 Blackwell 服务器版 GPU,可独立进行维护以实现快速扩展。
2
主机处理器模块 (HPM)
容纳双 NVIDIA Vera 处理器与 16 组 SOCAMM2 内存模块,可独立维护。